AI Agent 寫的程式要懂多少?實測二次方 bug 與 3 種底子
Agent 寫程式後,擁有者不必逐行讀,但要有認得異常的基礎、知道去哪查的廣度,和願意往下挖的臨場深度。我實跑 Claude 的七份輸出,六份是線性寫法,一份為了處理不可雜湊元素退回線性比對,耗時隨筆數加倍約乘 4。文末附檢查表。
目錄
原文在說什麼這個例子其實不太能說服人第一根支柱:二次方長什麼樣子實驗設定唯一的例外發現之後:把測量結果交還給 Agent一眼認出的方法警告出現時怎麼判斷:回頭看 SonarQube 那一關第二根支柱:廣度,是知道去哪裡問第三根支柱:臨場深度,卡關時的做法你可以現在做的檢查表常見問題Agent 寫的程式不用逐行讀,但這 3 種底子少不得:一個二次方 bug 的實測
一句話摘要:AI 寫程式之後,擁有者不必逐行看,但要有能認出異常的基礎、知道去哪查的廣度,以及願意往下挖的臨場深度。這篇用一篇 Hacker News 上 165 分的文章,加上我自己實跑的一段程式,示範第一根支柱長什麼樣子。
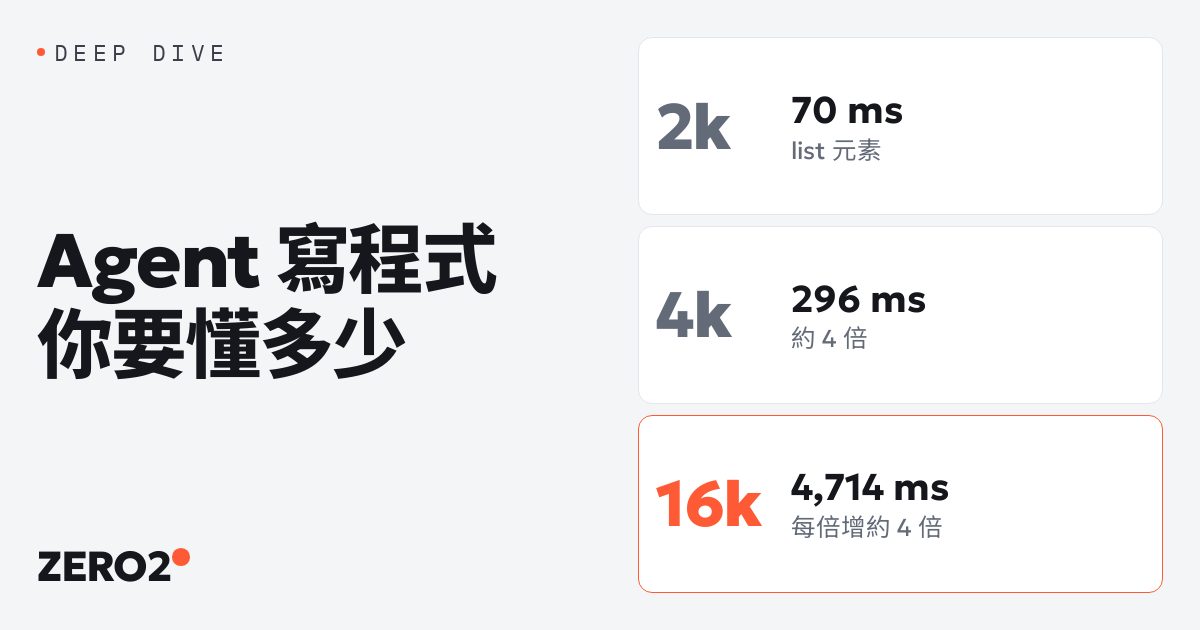
我請 Claude 寫一個合併兩份清單、去掉重複的函式。四個小任務、七份輸出,有六份是教科書寫法,只有一份在角落藏了一段會讓執行時間隨資料量平方成長的程式。元素是整數時,每份清單 16,000 筆只要 3 ms,看不出問題。換成 list 當元素,同樣筆數跑了 4.7 秒。
如果驗收標準只有「測試有過」,而測試資料剛好都是整數,這段程式就可能直接上線。這篇要談的就是這個缺口:Agent 寫的程式量已經超過你讀得完的量,你還需要懂多少,才算真的擁有這個系統。
原文在說什麼
blog.adrq.dev 上有一篇〈Here be monsters: What do you still need to know when agents do the work?〉,2026 年 10 月 27 日在 Hacker News 上被討論,我 10 月 28 日查到 165 分。原文沒標作者與發表日,我也無法直接抓取網頁,以下是我讀到的內容整理,引述都很短。
起因是一次 CI 失敗。作者的 App.tsx 被 SonarQube 以 cyclomatic complexity(循環複雜度)擋下。Codex 寫的 App.tsx 約 30 行,其中 15 行是整個元件寫在單獨一行。文中沒給複雜度分數與門檻,也沒說是什麼觸發了警告。作者格式化、讀過之後,認為複雜度合乎業務需求。他請 Codex「make SonarQube happy」,Codex 把程式拆成 10 個檔案,CI 就過了(拆檔細節據 HN 留言者 guitarlimeo 引述原文)。
作者用這件事主張:以前「擁有」一套系統的能力來自親手寫、親手除錯。Agent 把這條路切斷了,。所以他不贊成逐行讀每一行,也不贊成完全不看。他提出擁有者需要三根支柱:
- 基礎(Fundamentals):資料結構與 algorithms、網路、並行、分散式系統這類知識,用來辨認失敗的形狀,例如二次方變慢。
- 廣度(Breadth):夠用就好的各領域知識,目的是「知道出問題時該去查什麼」,原文把它比喻成指引你探索海洋的浮標。
- 臨場深度(Just-in-time depth):願意也有能力在陌生問題裡往下挖並弄懂,同時有自知之明,知道什麼時候該找人幫忙。
他舉的另一個案例是自己的 orchestrator。Agent 與 subagent 一直有穩定性和生命週期的 bug,後來他讀一本 Kubernetes 的書,想到 level-triggered(水位觸發)狀態機的概念,把架構從頭重設計,之後一直很穩。原文沒寫書名。
這個例子其實不太能說服人
我覺得值得先講這點,因為 HN 上有人直接指出來。留言者 guitarlimeo 的意思是:作者說要「往下挖」,結果做的事是叫 AI 把程式拆成 10 個檔案,這不算多深,一句 make SonarQube happy 就解決了。
這個批評成立。SonarQube 那個案例裡,作者的判斷是「複雜度有道理,工具的警告大概可以接受」,而最後的處理方式是順著工具走。它示範的是「看到警告時不放過」,還沒示範到「看得懂為什麼」。真正能支撐三根支柱的,是原文的另外兩個案例:二次方的時間曲線,和 orchestrator 的重設計。
第一根支柱:二次方長什麼樣子
原文的二次方例子用潛水機器人做比喻:深度 2 公尺回來要 4 秒,4 公尺要 16 秒,16 公尺要 256 秒。前兩點深度加倍,時間變四倍,到 16 公尺則是深度的平方。你不需要懂 Big-O 的定義,只要記得這個節奏:資料量乘 2,時間乘 4,就該停下來看看有沒有雙層迴圈藏在哪裡。
原文只給了比喻,我想知道 Claude 寫出來的程式會不會真的長這樣。所以我做了一個小實驗。
實驗設定
2026 年 10 月 28 日,用 claude -p 在空資料夾執行,系統提示是 You are Claude, a helpful AI assistant.,不開工具,不載入任何設定。我設計了四個日常小任務,其中三個各用 Haiku 與 Sonnet 跑一次,另一個只用 Sonnet 跑一次,共七份輸出。題目都是工程師每週會遇到的:依 id 去重並保留最新、找出重複字串、把訂單掛到使用者身上、合併兩份清單去重。原始輸出與指令都存在專案的 runs 資料夾裡。
結果出乎我意料:七份裡有六份用的是 set 或 dict,單次掃過資料,是線性的。例如把訂單掛到使用者身上,兩個模型都先把訂單按 user_id 分組,再逐一查表。沒有人寫雙層迴圈。
唯一的例外
剩下那份是 Sonnet 寫的 merge_unique。我給它的題目只有一句:「合併 a、b 兩個 list,回傳不重複的 list,保留順序。」它的輸出是:
def merge_unique(a, b):
    seen = set()
    result = []
    for item in a + b:
        try:
            if item in seen:
                continue
            seen.add(item)
        except TypeError:
            # 不可雜湊的元素,改用線性比對
            if item in result:
                continue
        result.append(item)
    return result
這段程式的主路徑沒有問題。它甚至想到了我沒提的情況:如果元素是 list 或 dict 這種不能放進 set 的東西,就退回去用 item in result 檢查。這個設計很周到,代價是隱藏的慢路徑,因為 item in result 每次都要掃整份 result,掃 n 次就是 n 的平方。
我用 Python 3.11.17 量了時間。耗時如下,n 是每份清單的筆數,兩份清單各 n 筆、有一半重疊:
| 元素類型 | n | 耗時 |
|---|---|---|
| 整數 | 2,000 | 0.2 ms |
| 整數 | 4,000 | 0.8 ms |
| 整數 | 8,000 | 0.9 ms |
| 整數 | 16,000 | 3.0 ms |
| list | 2,000 | 70.8 ms |
| list | 4,000 | 295.7 ms |
| list | 8,000 | 1,168.4 ms |
| list | 16,000 | 4,714.4 ms |
筆數加倍,時間約乘 4(我實測):70.8 到 295.7 是 4.2 倍,295.7 到 1168.4 是 3.95 倍,再到 4714.4 是 4.03 倍。這就是原文那條 4 秒、16 秒、256 秒的曲線,只是縮小成了毫秒。
先講限制:這是單一機器、單次測量,絕對數字不能拿來比;我也只用 list 當不可雜湊元素,而且每種任務只跑了一到兩次。另外,這次沒有測 Opus,也沒有換提示詞反覆跑,所以我不知道換個說法會不會讓更多輸出走到備援分支。這個實驗能支持的結論很窄:Claude 的常見輸出多半是線性的,但遇到「為了處理邊角情況而退回暴力比對」時,二次方就會藏進去,而且只測可雜湊元素的測試看不到。
發現之後:把測量結果交還給 Agent
量出差異之後,我的下一步是把數字和函式一起丟回給 Agent,沒有自己重寫。我同樣用 Sonnet,貼上上面那段程式和四個耗時,問原因與怎麼改才能保留對不可雜湊元素的支援。回答的重點是:list 不能放進 set,所以每個元素都掉進備援分支,對 result 做線性掃描,整體是 O(n²)。它建議把 list、dict、set 遞迴轉成可雜湊的鍵再去重,只有自訂的不可雜湊物件才走線性比對。
我把它給的新版本用同樣的資料再量一次,元素是 list,每份清單 2,000、4,000、8,000、16,000 筆時,耗時是 3.6、6.4、13.4、30.6 ms。16,000 筆從 4,714.4 ms 降到 30.6 ms,倍數也回到接近 2。順序很重要:先有倍數的觀察,才問得出「為什麼」,Agent 也才有數字可以對照。倍數回到 1.78、2.09、2.28,後兩次略高於 2,我沒有深究原因。
這一輪也只驗證了時間,沒有驗證語意。新版把 [1, 2] 和 (1, 2) 視為不同,與原版一致,是它自己在說明裡寫的,我沒有另外補測試。如果這是要上線的程式,這一步該由擁有者補上:用幾組邊角資料(空清單、巢狀 list、含 1 與 1.0 與 True 的混合清單)比對新舊輸出。
一眼認出的方法
以下是我自己讀程式時的習慣清單,不是原文或研究的結論:
- 迴圈裡面的
in list、list.index、list.remove,每一個都是隱藏的第二層迴圈。 - 迴圈裡面又呼叫了會掃整份資料的函式,例如每次都 filter 一次全部訂單。
- 為例外情況寫的備援分支,這種分支平常不會被測到,卻最可能是慢路徑。
- 字串在迴圈裡不斷用
+接長,在部分語言與情境下每次都會複製整份字串。
這四種都不用讀懂整個函式,掃一眼看到它們,就問一句「資料量乘 2,這裡會變怎樣」。基礎知識在 AI 時代的用法是這樣:你不必自己寫,只要在別人寫的程式裡看得出形狀。
警告出現時怎麼判斷:回頭看 SonarQube 那一關
原文那次 CI 失敗,如果用上面的做法重走一遍,會多出幾個動作。先問工具到底在量什麼:cyclomatic complexity 數的是程式裡獨立的分支路徑,與排版無關,所以元件寫成單行影響的是可讀性,不是分數。是哪個函式的分支太多,原文沒說,我不知道。再問這個數字對你有沒有意義:作者讀過之後覺得複雜度有道理,這是合理的判斷,但接下來應該記下理由,而不是只讓警告消失。
最後才是處理方式。拆成 10 個檔案讓 CI 通過,是可以接受的結果,因為拆開後每個元件應該比較容易單獨閱讀與測試(這是我的推測)。只是這個結果和「複雜度被降低」不是同一件事,我推測總分支數沒有減少,只是分散到不同檔案;文中沒有給拆分前後的分數,所以無從驗證。下次有人接手能不能比較快看懂,才是這次重構的價值,原文沒有量測這一點。
第二根支柱:廣度,是知道去哪裡問
廣度比較難示範,因為它是沒出事時看不出來的東西。我認為原文最有價值的一句,是廣度只需要「夠知道去查什麼」。
orchestrator 的案例就是這樣。作者在遇到問題後讀了一本 Kubernetes 的書,從中想到 level-triggered 的概念。這個案例也能解讀成臨場去讀書,屬於第三根支柱。我自己的解讀是,能在讀書時認出相似,靠的是事先對狀態機與控制迴圈已有概念,這部分原文沒寫。
HN 上有幾則留言補了實務面。smallerfish 提到,LLM 做資料庫 schema 的正規化決定很差,他在 AI 為主的專案裡每隔幾天就停下功能開發,做程式與 schema 審查。這跟二次方是同一種模式:每一次的小決定都能跑,累積起來才出事,而且 schema 一旦被資料綁住就很難改。以上是留言者自己的經驗,我沒有驗證,但它指出了哪些地方值得固定審查。
另一則來自 mrothroc,他說從一般工程師升到帶團隊後,團隊寫出的程式,他讀不到像親手寫那樣深,學到的是把系統看成「boxes and lines」:元件與它們的互動。他要求團隊交付循序圖,這樣就算每個方塊內部是黑的,邊界與流向還是清楚的。這是一個可以立刻照做的版本的「地圖」。
反方的意見也值得放進來。ArcaneMoose 說這張高層地圖常可由 AI 當場生成,你不用全懂,追問就能補上。我同意這在許多情境成立。但 EduardLev 的反駁我覺得更接近我的經驗:需要的脈絡往往橫跨多個 repo、設定檔,還有團隊的歷史與口耳相傳的決定,這些不在程式碼裡,AI 不一定拿得到。
第三根支柱:臨場深度,卡關時的做法
「願意往下挖」聽起來像態度問題,我覺得可以拆成三個動作。
先縮小範圍:把症狀換成一個可重複的最小案例。像上面那個函式,我只要寫三行 benchmark 就能重現慢。再問 Agent 之前,先自己形成一個猜測,哪怕是錯的。最後才是把猜測丟給 Agent 驗證,而不是丟一句「幫我修」。
這個順序有原因。如果什麼都不先想就問,我推測你會很難評斷 Agent 給的答案好不好。如果你有猜測,Agent 的回應就變成一個可以對照的資料點。原文結尾說,未來的擁有者會是整合這三根支柱的通才,像小時候拆收音機的人一樣,邊拆邊學。我同意方向,不過這個說法沒有證據,是作者的預期。
如果你是沒手寫過多少程式的初階工程師,我的看法是:沒有手寫過,就把「刻意練習看」當成替代。拿 Agent 的輸出,找一個你不熟的片段,花十分鐘問自己「資料量乘 10 會怎樣」。這是我自己的建議,不是原文提的,也沒有研究支持,只是我覺得成本最低。
你可以現在做的檢查表
把下面這份貼到你的 PR 範本或給 Agent 的指示裡,每次收 Agent 的程式時過一遍。
- 迴圈裡有沒有
in list、index、remove,或在迴圈裡呼叫掃全表的函式?有就問:資料量乘 2,這裡會變幾倍? - 有沒有為邊角情況寫的備援分支?它的複雜度是不是比主路徑高?
- 寫一個很短的 benchmark,至少量三個倍增的 n,每個重複幾次取最小值,單次耗時最好在數十毫秒以上。小 n 的雜訊會誤導,我的整數資料從 0.2 到 0.8 ms 也剛好是 4 倍,但那是線性程式。倍數穩定接近 4 才懷疑是二次方:
import timeit
for n in (4000, 8000, 16000):
    data = make_data(n)  # 換成你自己的資料產生器
    best = min(timeit.repeat(lambda: f(data), number=1, repeat=3))
print(n, best)- 工具警告(複雜度、型別、安全)要區分「這個警告為什麼出現」和「怎麼讓它消失」。只做後者,等於沒看。
- 資料庫 schema、對外 API 與資料格式這些難回頭的決定,不要只靠 Agent,排固定審查。
- 系統有沒有一張你講得出來的 boxes and lines?講不出來,就請 Agent 畫,再自己對照一次程式。
- 出事時的第一個問題:這是我認得的失敗形狀嗎?認不得,就是該往下挖或找人的時候。
HN 上也有人(alabhyajindal)覺得原文本身像 AI 寫的,這點我無法判斷。
這份清單在幾種情況下用處不大。資料量本來就小的腳本,二次方根本不會發作;一次性的資料轉換,慢一點也沒人在意;而對沒有資料量概念的問題,例如介面排版或文案,這些檢查完全沒有對應。它只適合會持續成長的資料與長期維護的服務。
這份清單不保證抓到所有問題。我實測的範圍只有 Python 的一小組函式,沒有碰到並行、分散式或前端,所以第一根支柱裡這一半的內容,我沒有自己的資料。
常見問題
我不是工程師,也要懂這些嗎? 如果你只是請 Agent 做自用小工具,不必。如果這套系統會被別人用、資料會累積、出事會有人受影響,你就是擁有者,至少要能問出「資料變十倍會怎樣」。
AI 也能幫我 review,為什麼還要自己懂? 可以,我在上面的實驗也是靠一個 benchmark 抓到問題。但我推測,讓同一類模型審查時,你還是得知道該問什麼,這點我沒有實測。
怎麼分辨 AI 寫壞了,還是工具誤報? 這就是原文與 HN 留言反覆爭論的地方。我的做法是:先做最小重現。能量到差異就是真問題,量不到就記下理由再決定是否接受警告。
資料來源(原文因 Cloudflare 擋下直接抓取,我是用網頁擷取工具取得摘要與逐項引述,不是全文,引述請以原文為準):
- Here be monsters: What do you still need to know when agents do the work?,blog.adrq.dev,擷取 2026-10-28
- Hacker News 討論 https://news.ycombinator.com/item?id=50258868(165 分,擷取 2026-10-28)
- 實跑紀錄:runs/ 資料夾(
claude -p,Haiku 與 Sonnet,Python 3.11.17,2026-10-28)
實測環境:單一機器、每題一到兩次,結果僅供參考。
常見問題
Agent 寫程式後,我還需要逐行讀嗎?
原文作者不贊成逐行讀,也不贊成完全不看。他認為擁有者需要基礎、廣度與臨場深度三種能力,能認出異常並往下查。
怎麼一眼看出二次方的慢?
資料量加倍、耗時約乘 4。我實測 Claude 寫的函式,元素為 list 時 2,000 到 16,000 筆耗時 70.8、295.7、1,168.4、4,714.4 ms。
Claude 寫的程式常有效能問題嗎?
我只測了四個小任務、七份輸出,六份是線性寫法,一份在備援分支退回線性比對。樣本很小,不能推論整體。